
Índice de contenidos
Claves de la noticia
- Nvidia y Cisco anuncian USFP, un formato óptico extraíble diseñado para señales eléctricas de 400 Gb/s por carril y redes de inteligencia artificial.
- Cisco sitúa la primera configuración de 16 carriles en 6,4 Tb/s; los 12,8 Tb/s corresponden a la ampliación futura a 32 carriles.
- Las empresas prevén una especificación abierta con varios proveedores, pero los documentos consultados no fijan fecha comercial, precios ni resultados independientes.
Nvidia y Cisco han presentado este 12 de octubre USFP, una propuesta para aumentar la capacidad de las conexiones ópticas de los centros de datos sin abandonar los módulos que se sustituyen por separado. El anuncio, realizado durante OCP Global Summit, apunta a un problema concreto: conectar más aceleradores dentro del espacio disponible para los puertos de red.
De 16 carriles a 32: dos capacidades distintas
USFP significa Ultra-Dense Small Form Factor Pluggable. El comunicado de Nvidia describe los primeros transceptores previstos con 16 carriles bidireccionales y una ocupación comparable a la del formato OSFP. Cada carril admite señales eléctricas de 400 Gb/s; el diseño contempla ampliar después la cantidad a 32 o más.
El blog firmado por los responsables de Cisco Bill Gartner y Will Eatherton aclara la relación entre esas cifras: 16 × 400 Gb/s son 6,4 Tb/s; con 32 carriles, el cálculo pasa a 12,8 Tb/s. Por tanto, el máximo que encabeza la comunicación comercial no debe confundirse con la primera configuración descrita. Tampoco hay que sumar envío y recepción para duplicar de nuevo la capacidad anunciada: Cisco ya explica qué agregado asocia a cada cantidad de carriles.
| Configuración | Cálculo nominal | Capacidad |
|---|---|---|
| Referencia óptica citada | Módulos actuales comparados | 1,6 Tb/s |
| USFP inicial previsto | 16 × 400 Gb/s | 6,4 Tb/s |
| Ampliación del diseño | 32 × 400 Gb/s | 12,8 Tb/s |
La comparación permite interpretar también el multiplicador de densidad: 6,4 dividido entre 1,6 equivale a cuatro. Es una relación de capacidad nominal en una ocupación comparable del frontal, no una medición de que una tarea de IA termine cuatro veces antes. El tiempo de ejecución dependerá además de los aceleradores, el tráfico, la topología y el software.
Más conexiones antes de añadir otra capa de red
Cuando un conmutador agota sus conexiones, ampliar un clúster puede exigir más niveles de conmutación y enlaces ópticos. Nvidia sostiene que duplicar tanto el número de carriles como su velocidad permite conectar más extremos de 1,6 Tb/s sin añadir esos niveles. La intención es aprovechar mejor la superficie destinada a conectores y reducir la complejidad de crecimiento.

Esto sitúa el anuncio en la misma cadena industrial que la capacidad de fabricación óptica comprometida por Lumentum hasta 2029: tener más capacidad de cálculo exige también mover datos entre máquinas. El nuevo formato aborda la densidad del módulo; no acredita por sí solo que ya existan suficientes unidades fabricadas para todos los despliegues.
La mejora energética cambia según lo que se compare
Las compañías anuncian aproximadamente 1,3 veces la eficiencia energética frente a ópticas de 200 Gb/s por carril. Ese dato necesita conservar su denominador. Si eficiencia significa caudal por vatio y la comparación mantiene el mismo caudal, la potencia necesaria sería 1/1,3 de la referencia: aproximadamente el 76,9 %, o un 23,1 % menos.
Es una conversión matemática del multiplicador publicado, no un ensayo propio ni una promesa de ahorro del centro de datos. Con cuatro veces el caudal y 1,3 veces la eficiencia, la potencia del módulo podría equivaler a 4/1,3, aproximadamente 3,08 veces la referencia. Ambas relaciones son compatibles: mejora la energía por bit aunque aumente la potencia al transportar muchos más bits.
Esta distinción evita trasladar el 1,3 a una reducción directa del 30 % en la factura eléctrica. El ahorro global necesitaría conocer cuántos módulos y conmutadores se utilizan, su carga y las capas de red que realmente se evitan. Los documentos consultados no proporcionan una configuración completa ni una prueba independiente para calcularlo.
Un conector nuevo conserva el mantenimiento por módulos
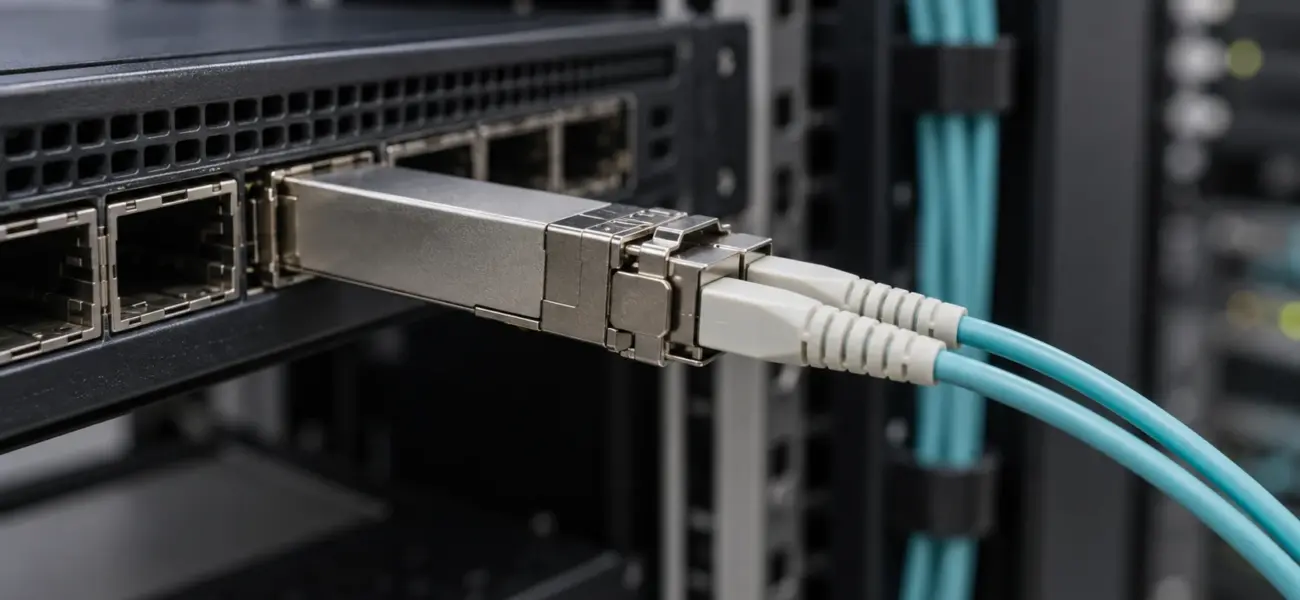
El cambio físico incluye una matriz bidimensional de contactos y una inserción en dos pasos. Según Nvidia, los contactos de alta velocidad se acoplan después de introducir el módulo, con el objetivo de reducir desgaste, mejorar integridad de señal y hacer más predecible la fuerza de inserción.
El formato soporta disipar hasta 100 vatios sin un circuito de refrigeración integrado y dedicado dentro del transceptor. Esa cifra describe una capacidad térmica; no establece que todos los módulos consumirán 100 vatios. También es relevante la localización de la refrigeración: prescindir de ese circuito interno no elimina la necesidad de evacuar calor en el equipo.
Cisco encuadra USFP junto a otras arquitecturas ópticas, incluidas las cercanas al encapsulado y las integradas con él. Su argumento a favor de los módulos extraíbles es operativo: sustitución independiente en campo, cadenas de suministro maduras y mantenimiento conocido. La elección no se resuelve solo con terabits; también depende de cómo se reemplaza un componente averiado y de qué proveedores puede utilizar el operador.
La especificación abierta todavía es un proyecto
TE Connectivity y Amphenol colaboran en jaulas, conectores y módulos. Nvidia y Cisco prevén crear una especificación abierta mediante un futuro proyecto comunitario con varios suministradores. El anuncio expresa esa intención; no equivale a una especificación final ya adoptada por toda la industria ni garantiza intercambiabilidad universal con equipos OSFP existentes.
La propuesta de Upscale para integrar las redes de IA ofrece otro contexto de este problema: el sistema necesita coordinar componentes y capas distintas. En USFP, mantener una ocupación física comparable y prácticas de mantenimiento familiares tampoco sustituye la validación del conector, la señal eléctrica, la óptica y el conmutador concretos.
La publicación oficial de Cisco sobre USFP presenta el equilibrio entre capacidad futura y operación actual. Resume la dirección del diseño y permite consultar el anuncio de la empresa; no aporta un benchmark adicional.
Scaling #AI networks to 12.8T requires new design concepts. Cisco and @nvidia are collaborating on the USFP form factor to balance future capacity with current operations. Learn more about the vision ➡️ https://t.co/4SMg1hp0Sw#Networking pic.twitter.com/Dwvyo5ODBj
— Cisco (@Cisco) October 12, 2026
La conclusión práctica es precisa: el primer escalón descrito es 6,4 Tb/s y los 12,8 Tb/s requieren ampliar el diseño. Para evaluar una compra harán falta productos, plazos y pruebas de compatibilidad. Hoy hay una arquitectura anunciada y relaciones de capacidad comprobables, pero no una ficha comercial suficiente para prometer ahorro eléctrico o disponibilidad inmediata.
Imagen: ilustración conceptual generada; no representa un módulo USFP real.