




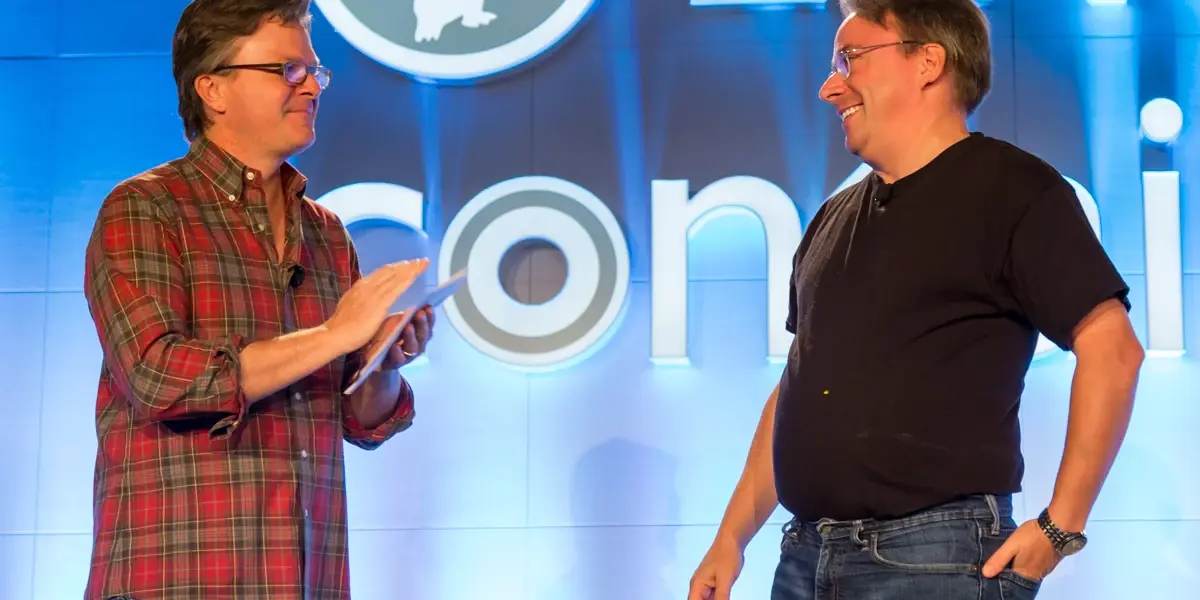
Torvalds usa Claude Code en Linux: más velocidad y un coste de memoria

Índice de contenidos
Claves de la noticia
- Torvalds atribuye a Claude Code el código y las pruebas de una propuesta experimental para leer archivos desde la caché de Linux.
- Los resultados cambian según la carga: ocho hilos sobre el mismo archivo mejoran mucho, pero una lectura que necesita resolver un fallo de página empeora.
- La memoria pendiente de liberar y las comprobaciones de seguridad siguen siendo obstáculos; el trabajo no equivale a una mejora disponible en las distribuciones.
Linus Torvalds ha desarrollado con Claude Code una propuesta para aliviar la competencia entre procesadores al leer archivos ya presentes en memoria. Phoronix dio a conocer el nuevo ramo de trabajo durante la madrugada del 12 de octubre en España. Su interés va más allá del asistente empleado: las mediciones publicadas muestran una ganancia muy localizada y un coste que impide describir el experimento como un Linux más rápido en general.
Un trabajo experimental con autoría declarada
Michael Larabel, de Phoronix, identificó el ramo noref-filemap-read-with-llm en el repositorio de Torvalds mientras esperaba Linux 7.3-rc7. El documento técnico conservado en el espejo universitario de HUST está fechado el 10 de octubre. Conviene distinguir esa fecha del momento en que la reportería hizo visible el trabajo: ni el código nació hoy ni su aparición pública acredita su integración en el núcleo principal.
La sección dedicada a las herramientas atribuye a Claude Code el código, los programas de prueba, la revisión de problemas pendientes y el primer borrador de la explicación, bajo la dirección de Torvalds. Las mediciones se ejecutaron en su equipo. Es una declaración concreta de método, no una evaluación independiente de cuánto trabajo ahorró la IA. Tampoco ofrece una comparación controlada con la misma tarea realizada sin asistente.
Para los desarrolladores, la diferencia es relevante: producir un parche y demostrar que puede aceptarse son etapas distintas. Esa separación también ayuda a interpretar el debate sobre la confianza de los programadores en la IA y sus límites. Aquí quedan identificados tanto el autor responsable como los resultados que todavía deben reproducirse.
Leer sin disputar el mismo contador
La caché de páginas conserva datos de archivos en memoria para evitar nuevas lecturas del almacenamiento. Cuando varios hilos acceden a la misma zona, pueden competir por los metadatos que controlan cuánto tiempo debe mantenerse disponible. El problema no consiste necesariamente en esperar al disco: los datos ya están cerca del procesador, pero coordinar su uso también cuesta.
La documentación de RCU del kernel explica la alternativa conceptual. RCU separa retirar un elemento de una estructura y recuperar después su memoria. Los lectores que ya estaban utilizándolo pueden terminar antes de que esa memoria se reutilice. Ese intervalo de espera permite aligerar la sincronización del lado de la lectura.
Es una distinción técnica decisiva: quitar un dato de la caché no obliga a reciclar inmediatamente su espacio. La propuesta aplica esa espera a la liberación y utiliza un recorrido de lectura que evita tomar referencias en los casos compatibles. El beneficio potencial procede de reducir coordinación repetida; el coste aparece donde hay que conservar memoria que otros trabajos podrían necesitar.
The Linux Foundation ofrece una explicación histórica de Paul E. McKenney, responsable de RCU, en el seminario sobre los fundamentos de RCU grabado en diciembre de 2021. La descripción oficial trata la publicación de punteros y la espera a los lectores previos. Sirve como contexto técnico; no presenta ni valida los parches de Torvalds de 2026.
La misma comparación arroja mejoras y retrocesos
Para comparar el coste, hemos calculado la variación de los ciclos del kernel por lectura usando el punto medio de cada rango publicado: (valor nuevo − valor anterior) / valor anterior × 100. No son pruebas nuevas ni porcentajes de aceleración de una aplicación completa. Un valor negativo indica menos ciclos necesarios; uno positivo, más.
| Prueba | Base | Propuesta | Variación |
|---|---|---|---|
| Un hilo, archivo en caché | 452–454 | 408–409 | −9,8 % |
| Ocho hilos, mismo archivo | 2.937–2.975 | 725–726 | −75,5 % |
| Un hilo, página de destino ausente | 4.117–4.188 | 6.543–6.593 | +58,2 % |
La mejora de la carga compartida convive con un empeoramiento superior al 50 % en otra prueba pequeña. Esa comparación impide trasladar el resultado más favorable a cualquier lectura. Una aplicación puede recorrer varias rutas durante su ejecución, de modo que el balance depende de cuáles utilice y con qué frecuencia.
Torvalds probó en un Core i7-8565U, con cuatro núcleos y ocho hilos, ext4 y determinadas protecciones desactivadas. También advierte de variaciones térmicas, por lo que prefiere comparar coste por operación a lecturas por segundo. Las cifras permiten estudiar un cuello de botella; no sustituyen mediciones con la configuración de seguridad de un servidor real.
La memoria retenida cambia el criterio de aceptación
La otra pregunta es si acelerar a los lectores perjudica a quienes necesitan memoria libre. Una página retirada pero todavía pendiente del período de gracia no puede entregarse a otra tarea. Si la recuperación se retrasa demasiado, el sistema puede sufrir presión de memoria aunque parte de ese espacio esté esperando ser reutilizado.
El documento enumera problemas pendientes y pruebas que no se han realizado. Por eso, comprobar únicamente que el compilador acepta el código dejaría sin respuesta la cuestión central: cómo se comporta cuando hay muchas lecturas, liberaciones y necesidades de memoria simultáneas. La supervisión del asistente también incluye verificar supuestos del diseño, una responsabilidad relacionada con los controles para agentes de programación en VS Code, aunque aquí se evalúe un cambio del kernel.
Para administradores y desarrolladores españoles, la consecuencia práctica es concreta: este experimento no justifica cambiar de kernel ni prometer una aceleración a sus usuarios. Sí ofrece una hipótesis reproducible para investigar cargas que comparten archivos. Su valor demostrable reside en haber expuesto juntos el beneficio, la regresión y las comprobaciones pendientes, permitiendo que la revisión técnica juzgue el intercambio entre tiempo de CPU y disponibilidad de memoria.
Imagen: Linux Foundation / Wikimedia Commons. «Linus Torvalds and Jim Zemlin», fotografía de archivo de LinuxCon North America en Toronto, 24 de agosto de 2016, con licencia CC BY 2.0. Original y atribución. Conversión y compresión a WebP; recorte permitido con atribución y aviso de cambios.





